


产品逻辑总览

在动手操作之前,先理解平台的分层设计与角色分工,可以避免在“模型、推理引擎、部署、服务提供者、网关、套餐、密钥”之间反复跳转。本平台与 OpenAI、火山方舟、阿里云百炼等主流 MaaS 产品的设计思路一致:把“把模型跑起来”和“让外部安全地调用模型”拆成两条链路,用网关做统一收口。
平台分层架构
一次模型调用从下到上分为六层,每层只做一件事:
模型文件层:模型权重本身,存放在《模型仓库》,可在线导入或手动上传。
推理引擎层:定义模型用什么运行时(镜像、CPU/内存/加速卡、启动命令与参数),存放在《推理引擎》。
模型部署层:把模型文件与推理引擎绑定成一个可运行实例,设置副本数与服务名,存放在《模型部署》。
AI 服务提供者层:把运行中的部署封装成可被网关发现的“后端服务”,并区分内部部署与外部公有云 API(OpenAI、DeepSeek 等),存放在《AI 服务提供者》。
模型网关层:对外暴露统一域名,按模型名把请求路由到一个或多个后端,支持优先级、权重负载均衡与故障切换,存放在《模型网关》。
套餐与密钥层:套餐规定所管理的路由的请求数与 Token 数上限;API Key 绑定套餐后即成为调用凭证,存放在《套餐管理》与《API Key》。
一次调用的数据流
以一次对话请求为例:应用向 https://<路由域名>/v1/chat/completions 发起 HTTPS 请求,带上 Authorization: Bearer sk-… 请求头;模型网关校验密钥身份,确认该 Key 所属套餐允许访问此路由且未超限流;随后按请求体中的 model 字段,在路由配置中找到对应的后端 AI 服务提供者;请求被转发到模型部署实例上的 vLLM 服务,推理结果沿原路返回。理解这条链路后,后面每一步操作的目的都会很清晰:前面的菜单都在为这条链路“接线”。
大模型服务使用流程
大模型服务云产品的主线使用流程及具体说明如下: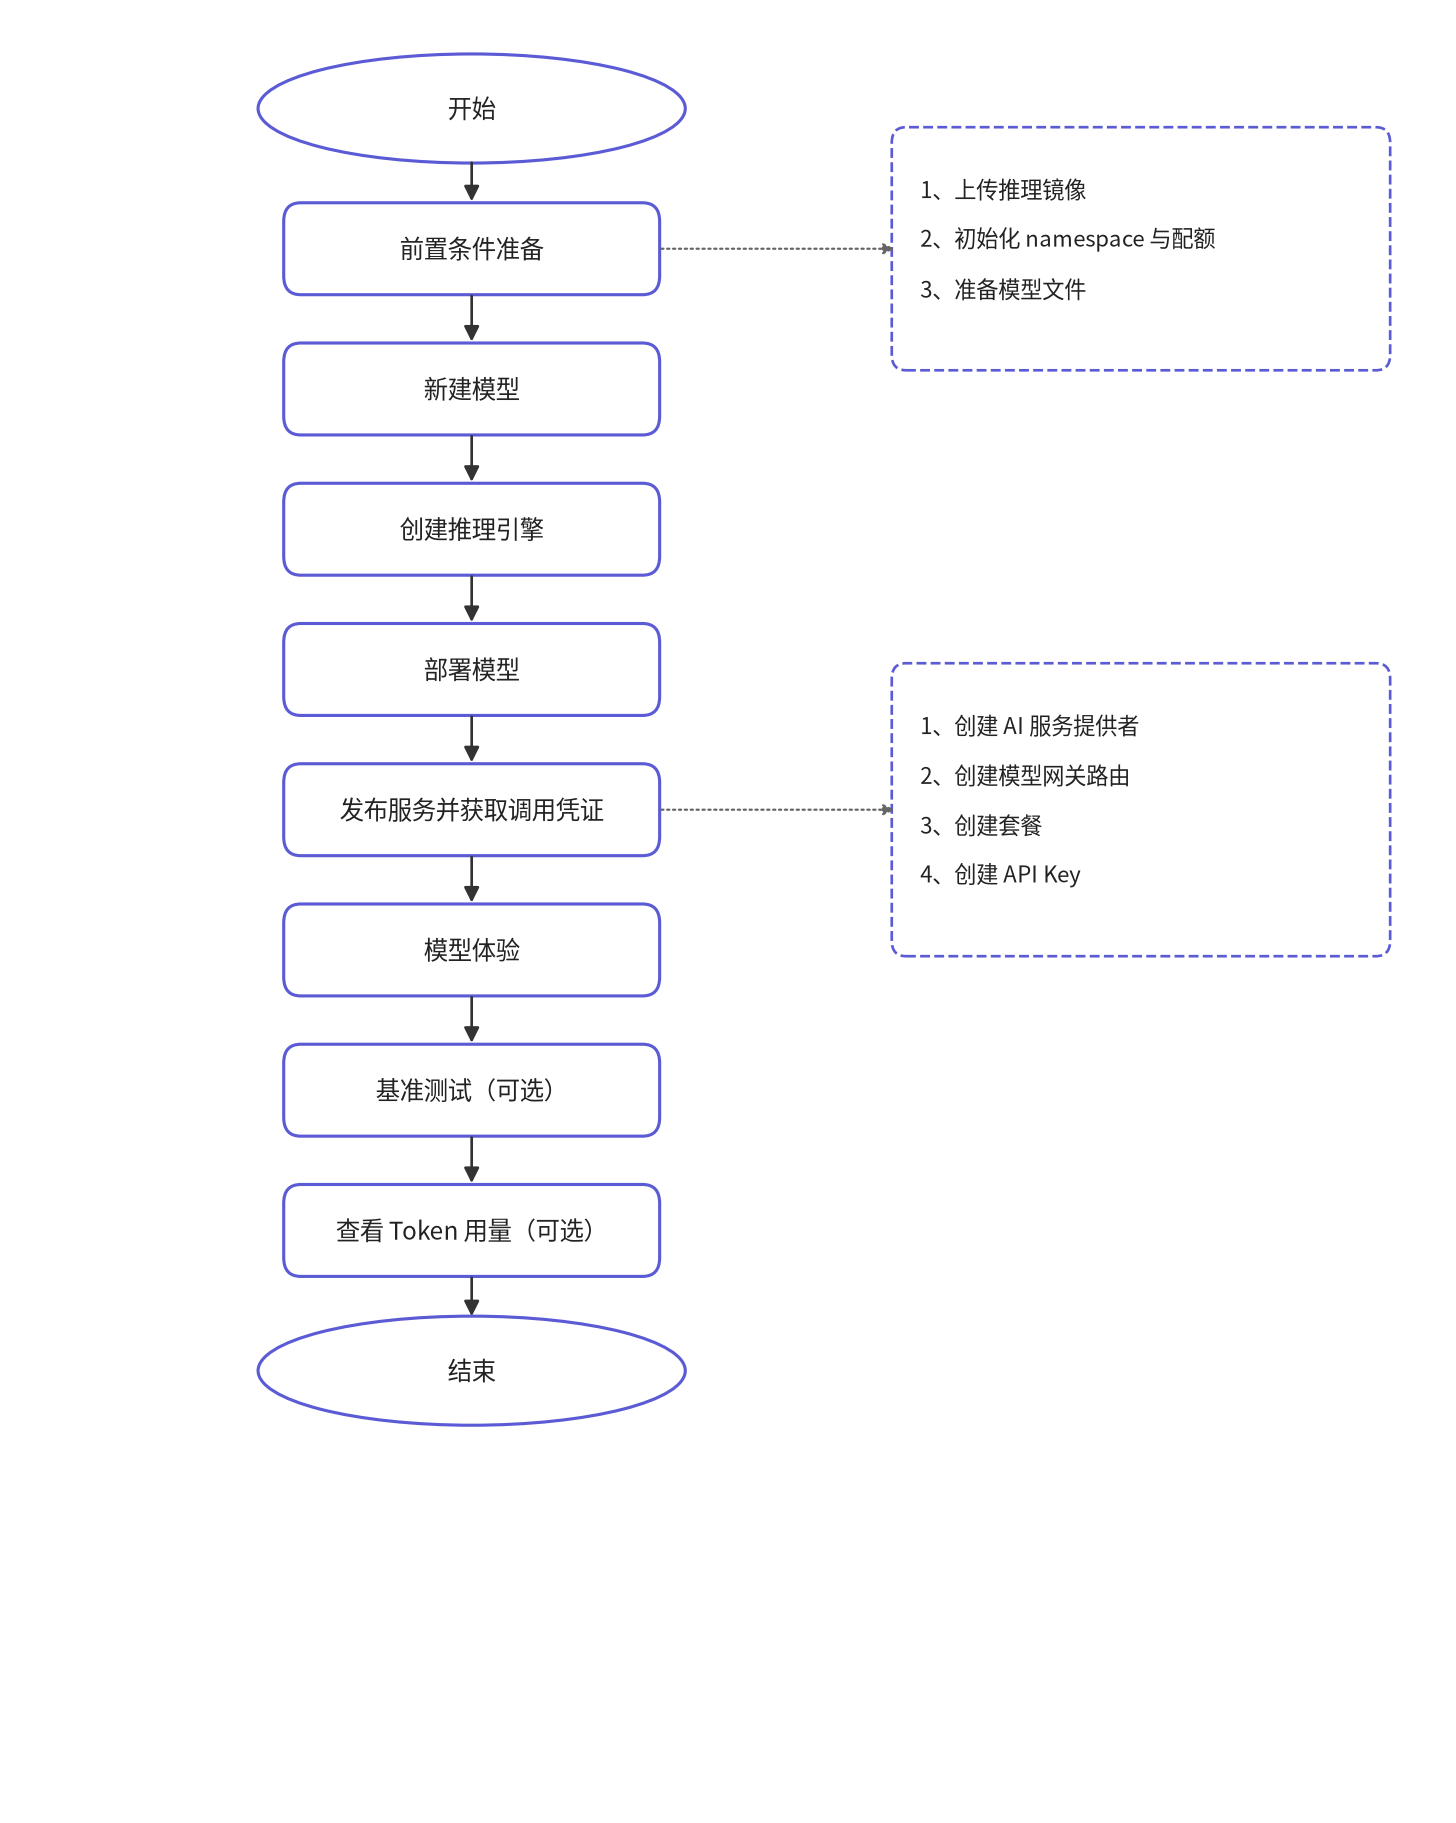
快速上线操作流程
快速上线操作流程如下所示:
| 操作流程 | 描述 | |
|---|---|---|
| 前置条件准备 | 上传推理镜像 | 通过 ctr 或 docker 将推理镜像上传到容器镜像服务引擎仓库,需打标签的镜像在详情页设置。 |
| 初始化 namespace 与配额 | 项目管理员在《模型广场》初始化项目 namespace,并在《配额设置》按安全容器服务配置项目所需的加速卡与资源配额。 | |
| 准备模型文件 | 通过 ModelScope 在线导入,或下载模型包解压后在《模型仓库》创建上传任务,为新建模型准备可绑定的模型文件。 | |
| 新建模型 | 新建模型 | 在《模型广场》点击“新建模型”,选择“绑定已有模型文件”,填写模型名称并选择上一步准备好的模型文件。 |
| 发布服务并获取调用凭证 | 创建推理引擎 | 在《推理引擎》选择 AI 加速卡型号,选择自动带出的镜像,使用平台默认启动命令与启动参数,按需调整资源规格。 |
| 部署模型 | 在《模型部署》新建部署,选择模型与推理引擎,设置副本数后点击创建,等待模型部署状态变为就绪。 | |
| 发布服务并获取调用凭证 | 创建 AI 服务提供者 | 在《AI 服务提供者》类型选择“内部”,选择刚部署的模型,集群内部访问地址自动带出。 |
| 创建模型网关路由 | 在《模型网关》创建路由,填写二级域名,将模型映射到刚创建的 AI 服务提供者,按需配置优先级、权重与访问控制。 | |
| 创建套餐 | 在《套餐管理》创建套餐,设置每秒请求数与每秒 Token 数上限,可访问路由选择刚刚创建的路由。 | |
| 创建 API Key | 在《API Key》创建 API Key,选择刚刚创建的套餐并“创建并签发密钥”,成功后立即复制密钥(密钥仅显示一次)。 | |
| 模型体验 | 模型体验 | 在《模型体验》粘贴 API Key,选择路由与模型,按能力使用对话、图片生成、视觉 OCR 或语音页签验证服务可用。 |
| 基准测试(可选) | 基准测试(可选) | 在《基准测试》创建测试,选择已部署模型与测试类型,测量延迟与吞吐,无压测需求可跳过。 |
| 查看 Token 用量(可选) | 查看 Token 用量(可选) | 在《Token 用量》查看调用汇总与最近请求明细,确认计费与调用情况,上线验证后可按需查看。 |


