


本章节主要介绍如何通过模型体验页面测试模型能力,包括对话、图片生成、视觉/OCR和语音等。模型体验通过模型网关调用目标模型,需要选择网关路由和模型并填写API Key。在云平台顶部导航栏中,依次选择[产品与服务]-[大模型服务]-[模型体验],即可进入“模型体验”页面。
准备工作

使用模型体验前,请确认已经完成以下操作:
- 已经创建模型网关路由,并为路由配置需要体验的模型和后端。
- 已经创建可用于调用模型网关的API Key。
- 目标模型支持需要体验的能力,例如对话、图片生成、视觉/OCR或语音。
选择体验模型
进入“模型体验”页面后,根据需要选择对话、图片生成、视觉/OCR或语音页签。
不同体验类型均需要完成以下配置:
- 在
API Key中粘贴用于调用模型网关的API Key。 - 在模型体验区域中选择目标路由。
- 选择该路由中需要体验的模型。
- 根据当前体验类型输入请求内容并发送。
说明:
- API Key仅在当前会话中保留。
- 页面右上角提供不同的体验区布局,可用于切换同时显示的模型体验区域数量。
- 单击模型体验区域右上角的“最大化”图标,可展开当前体验区域。
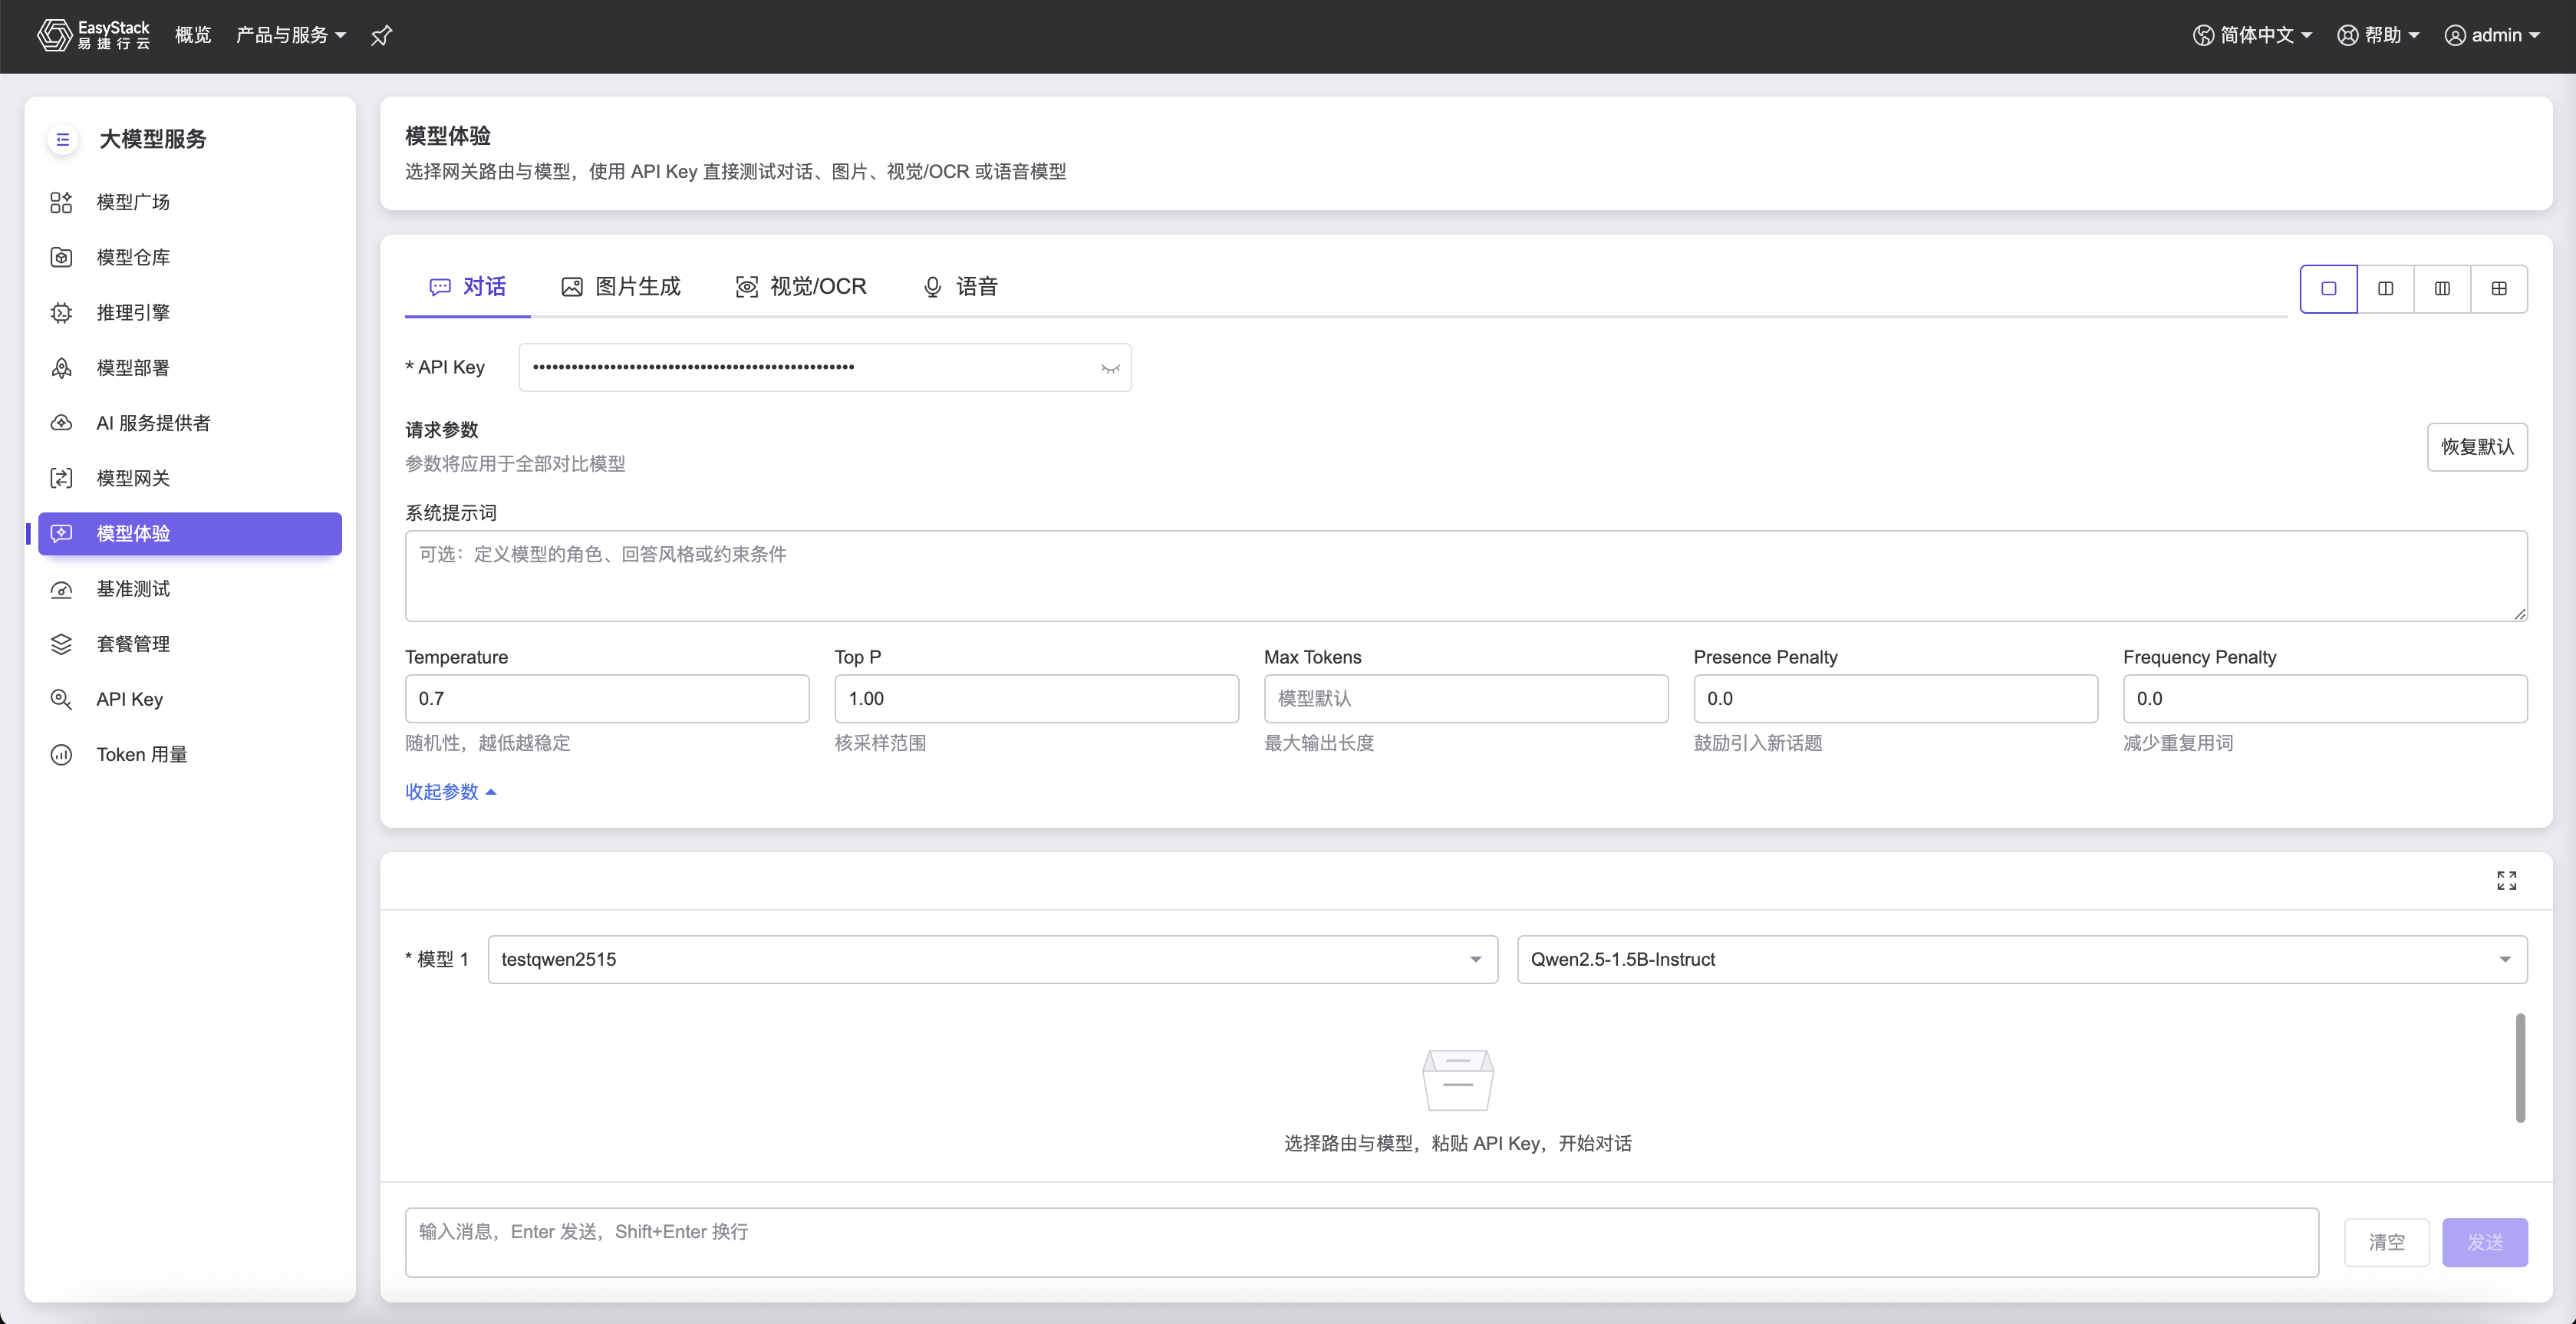
对话体验
对话体验用于向对话模型发送消息并查看模型回复。
- 在“模型体验”页面中,选择
对话页签。 - 填写API Key。
- 根据需要配置请求参数。
- 选择目标路由和对话模型。
- 在页面底部输入消息。
- 单击
发送或按Enter键,向模型发送消息。
输入多行消息时,按Shift+Enter换行。
配置请求参数
对话请求参数将应用于当前页面中参与对比的全部模型。
| 参数 | 说明 |
|---|---|
| 系统提示词 | 用于定义模型角色、回答风格或其他约束条件。 |
| Temperature | 控制回复的随机性。参数值越低,生成结果越稳定。 |
| Top P | 控制模型生成内容时的核采样范围。 |
| Max Tokens | 设置模型回复的最大输出长度。未设置时使用模型默认值。 |
| Presence Penalty | 控制模型是否倾向于引入新的话题。 |
| Frequency Penalty | 控制模型是否减少重复用词或重复内容。 |
单击收起参数可隐藏请求参数区域。需要恢复默认配置时,可单击恢复默认。
需要清除当前对话内容时,可单击清空。
图片生成体验
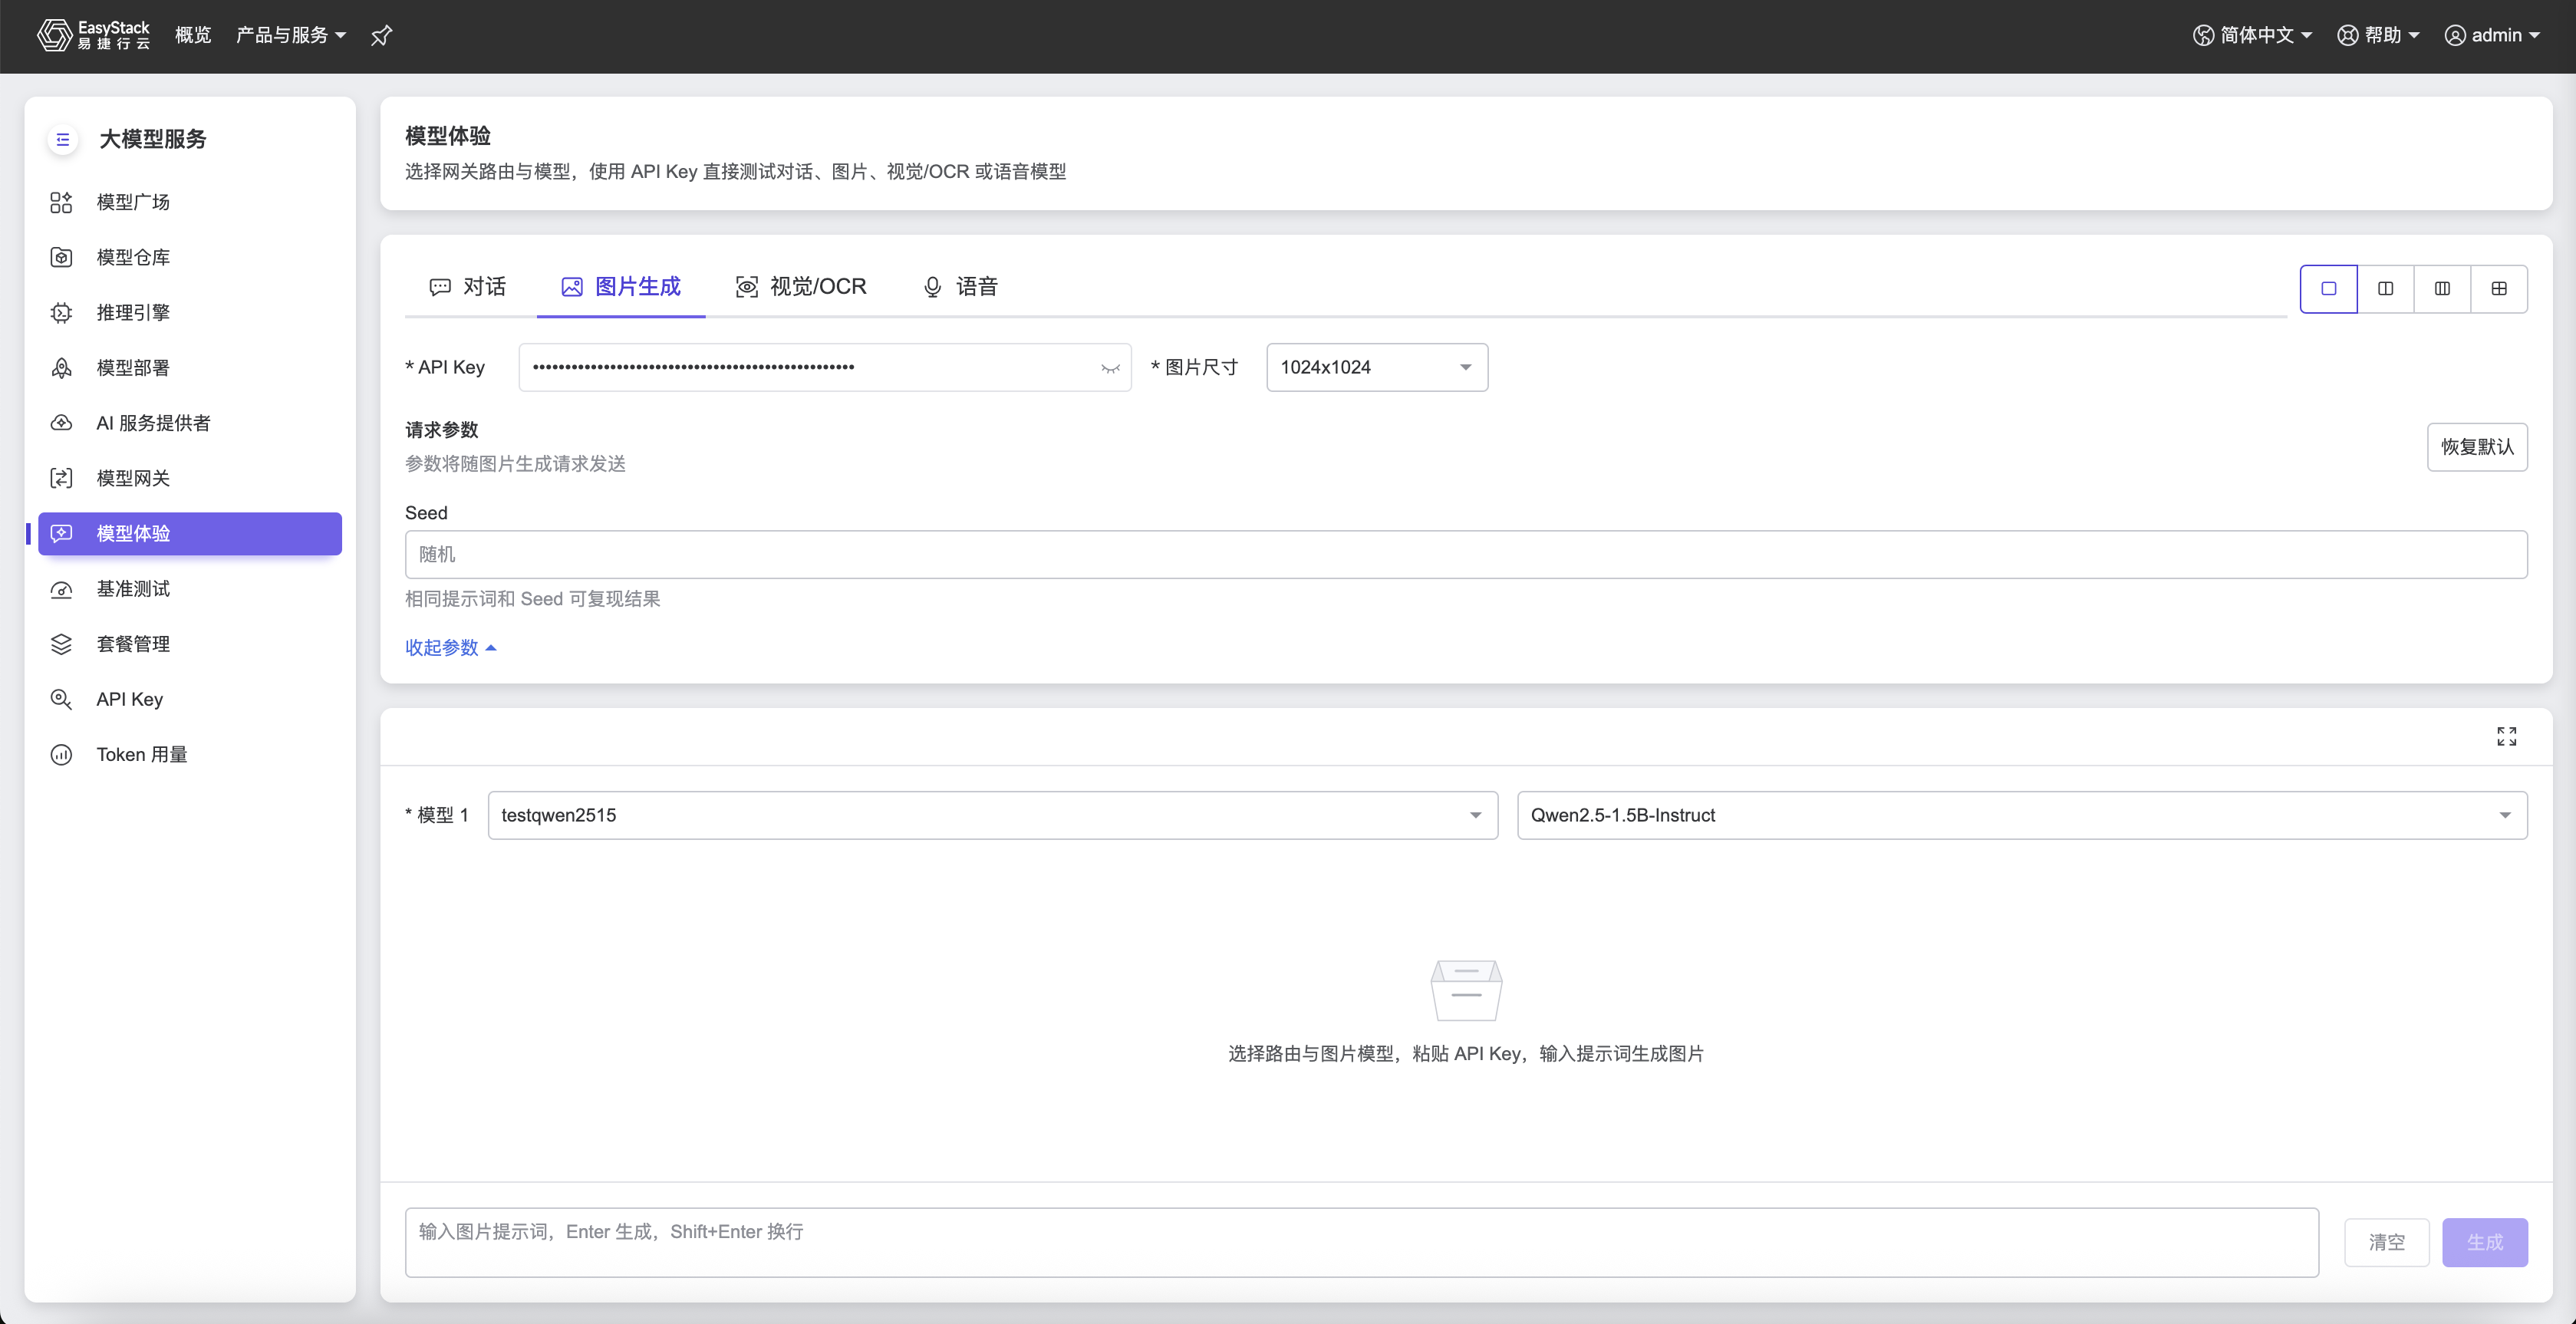
图片生成体验用于根据文本提示词生成图片。
- 在“模型体验”页面中,选择
图片生成页签。 - 填写API Key。
- 配置图片生成参数。
- 选择目标路由和图片生成模型。
- 在页面底部输入图片提示词。
- 单击
生成或按Enter键,生成图片。
输入多行提示词时,按Shift+Enter换行。
| 参数 | 说明 |
|---|---|
| 图片尺寸 | 生成图片的尺寸,例如1024 × 1024。 |
| Seed | 图片生成使用的随机种子。使用相同的提示词和Seed,可以复现相同或相近的生成结果。 |
单击收起参数可隐藏请求参数区域。需要清除当前生成内容时,可单击清空。
视觉/OCR体验
视觉/OCR体验用于上传图片并执行文字识别、图片描述等视觉任务。
- 在“模型体验”页面中,选择
视觉/OCR页签。 - 填写API Key。
- 单击图片选择区域,上传需要处理的图片。
- 选择目标路由和视觉模型。
- 在页面底部输入提示词,例如“识别图片中的文字”。
- 单击
识别或按Enter键,发送视觉识别请求。
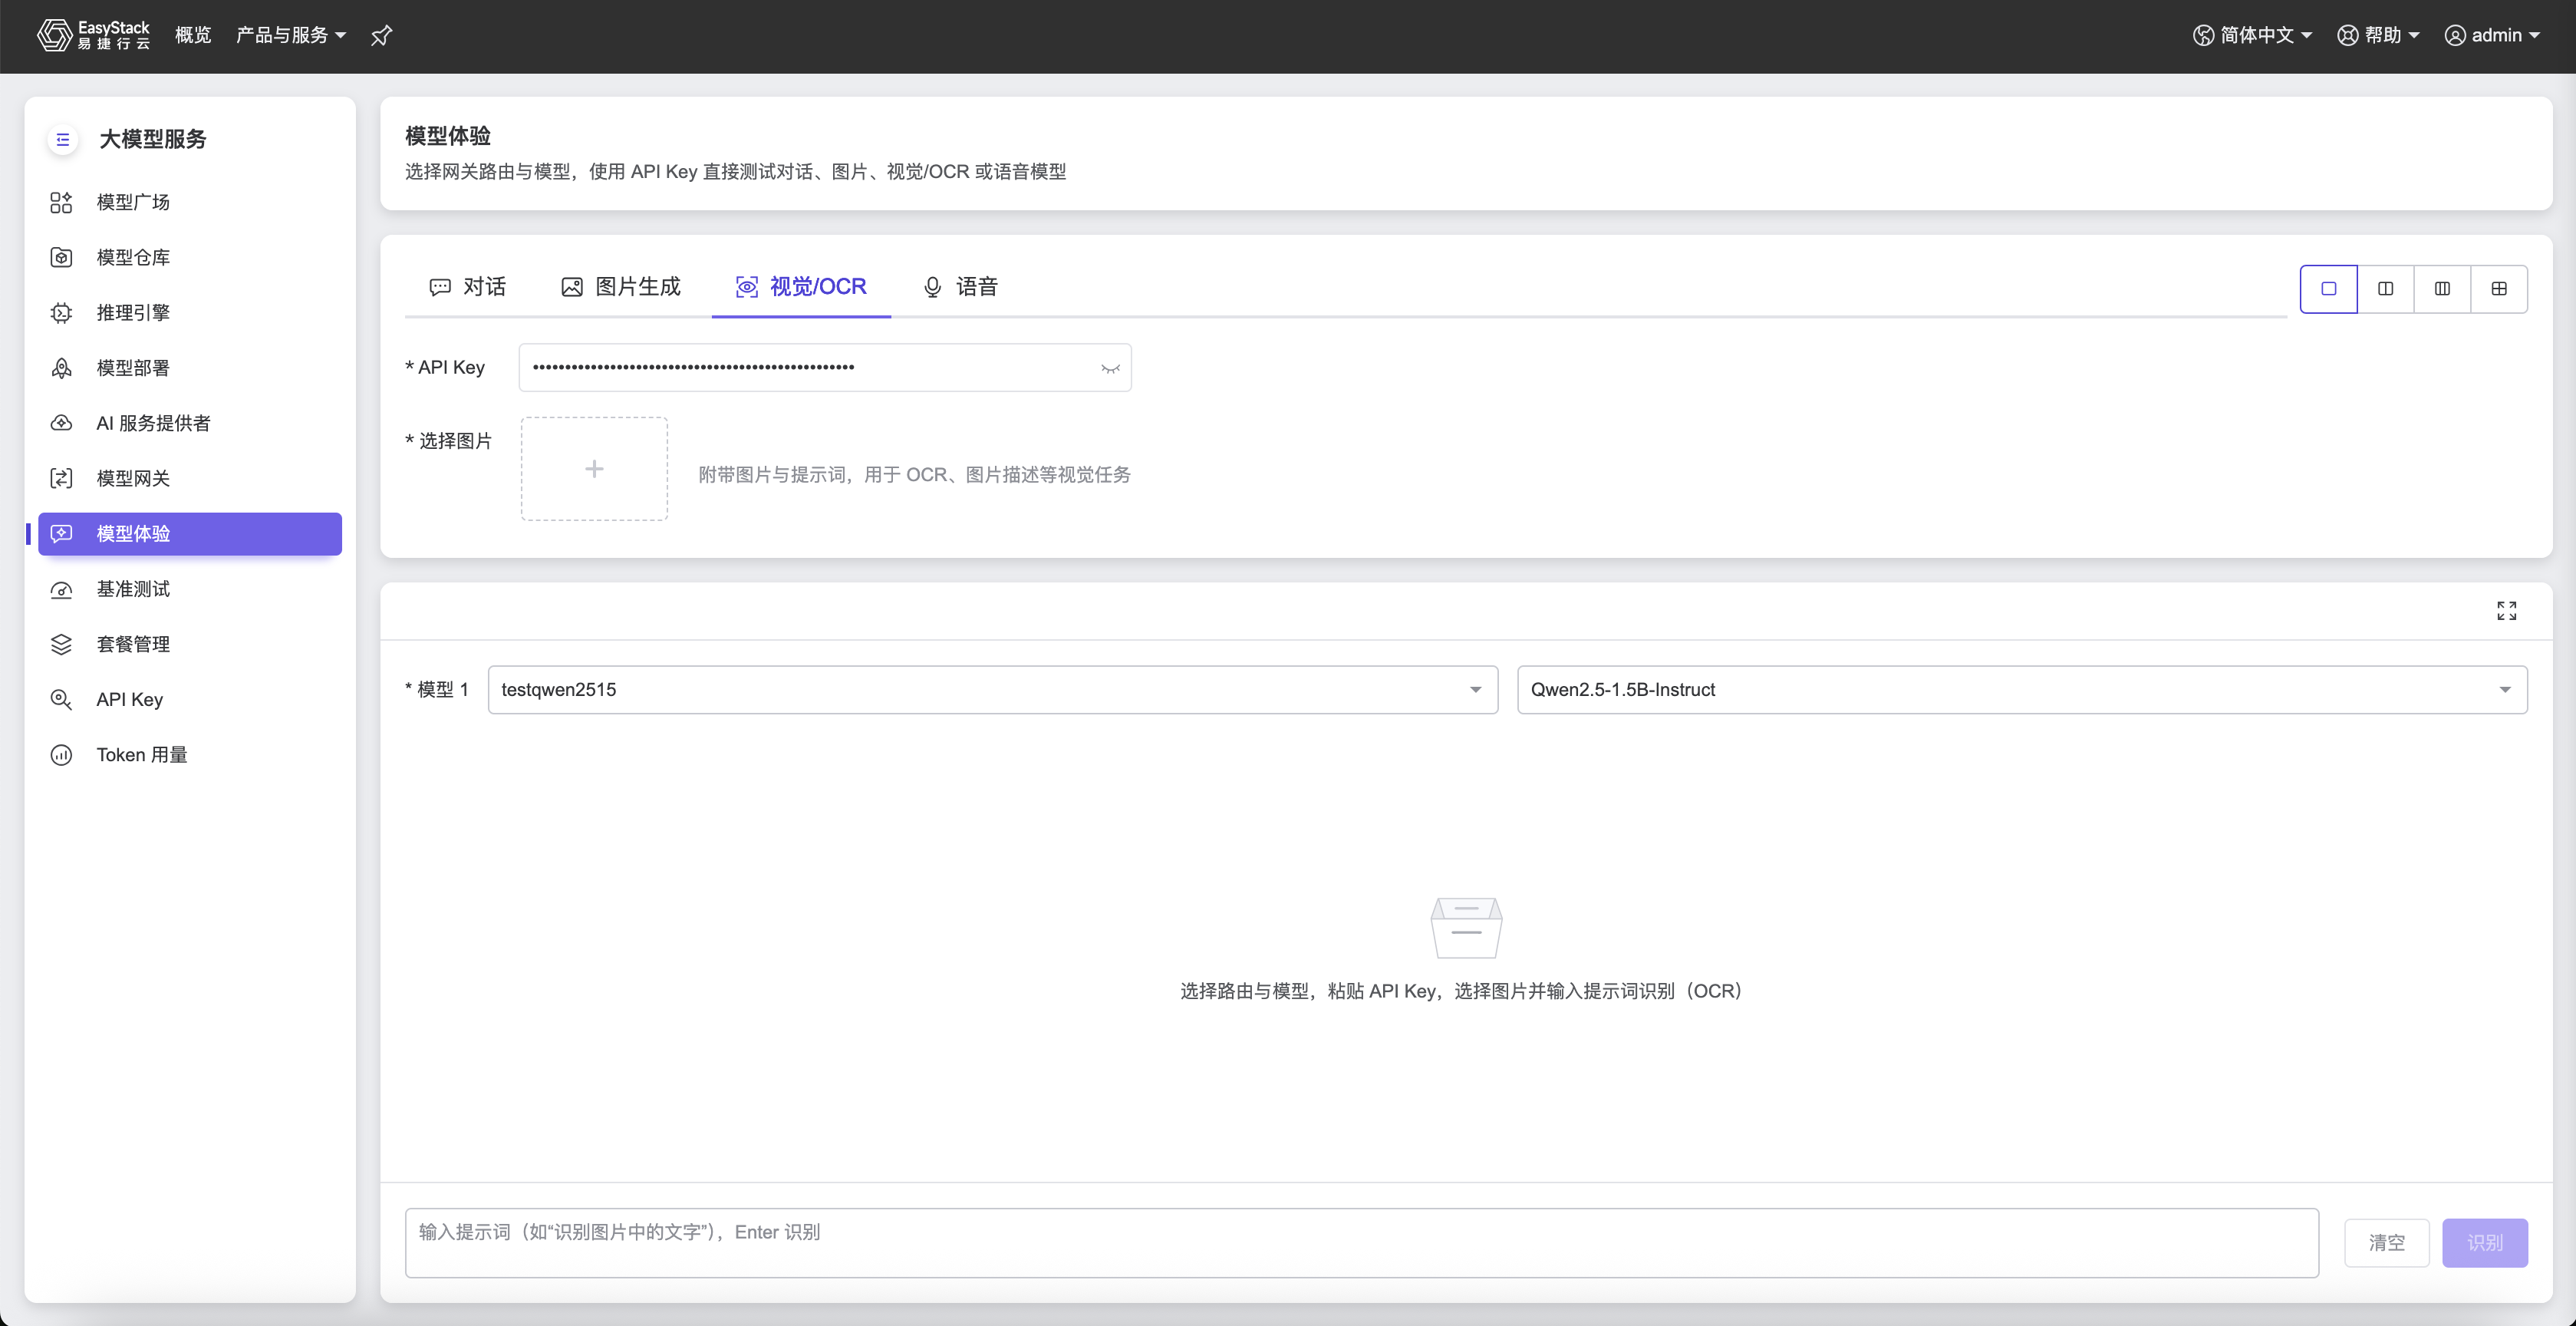
上传的图片将与提示词一同发送至目标模型。请根据具体任务,在提示词中说明需要模型执行的操作。
需要清除当前图片和识别内容时,可单击清空。
语音体验
语音体验支持文本转语音和语音转文本两种模式。
文本转语音
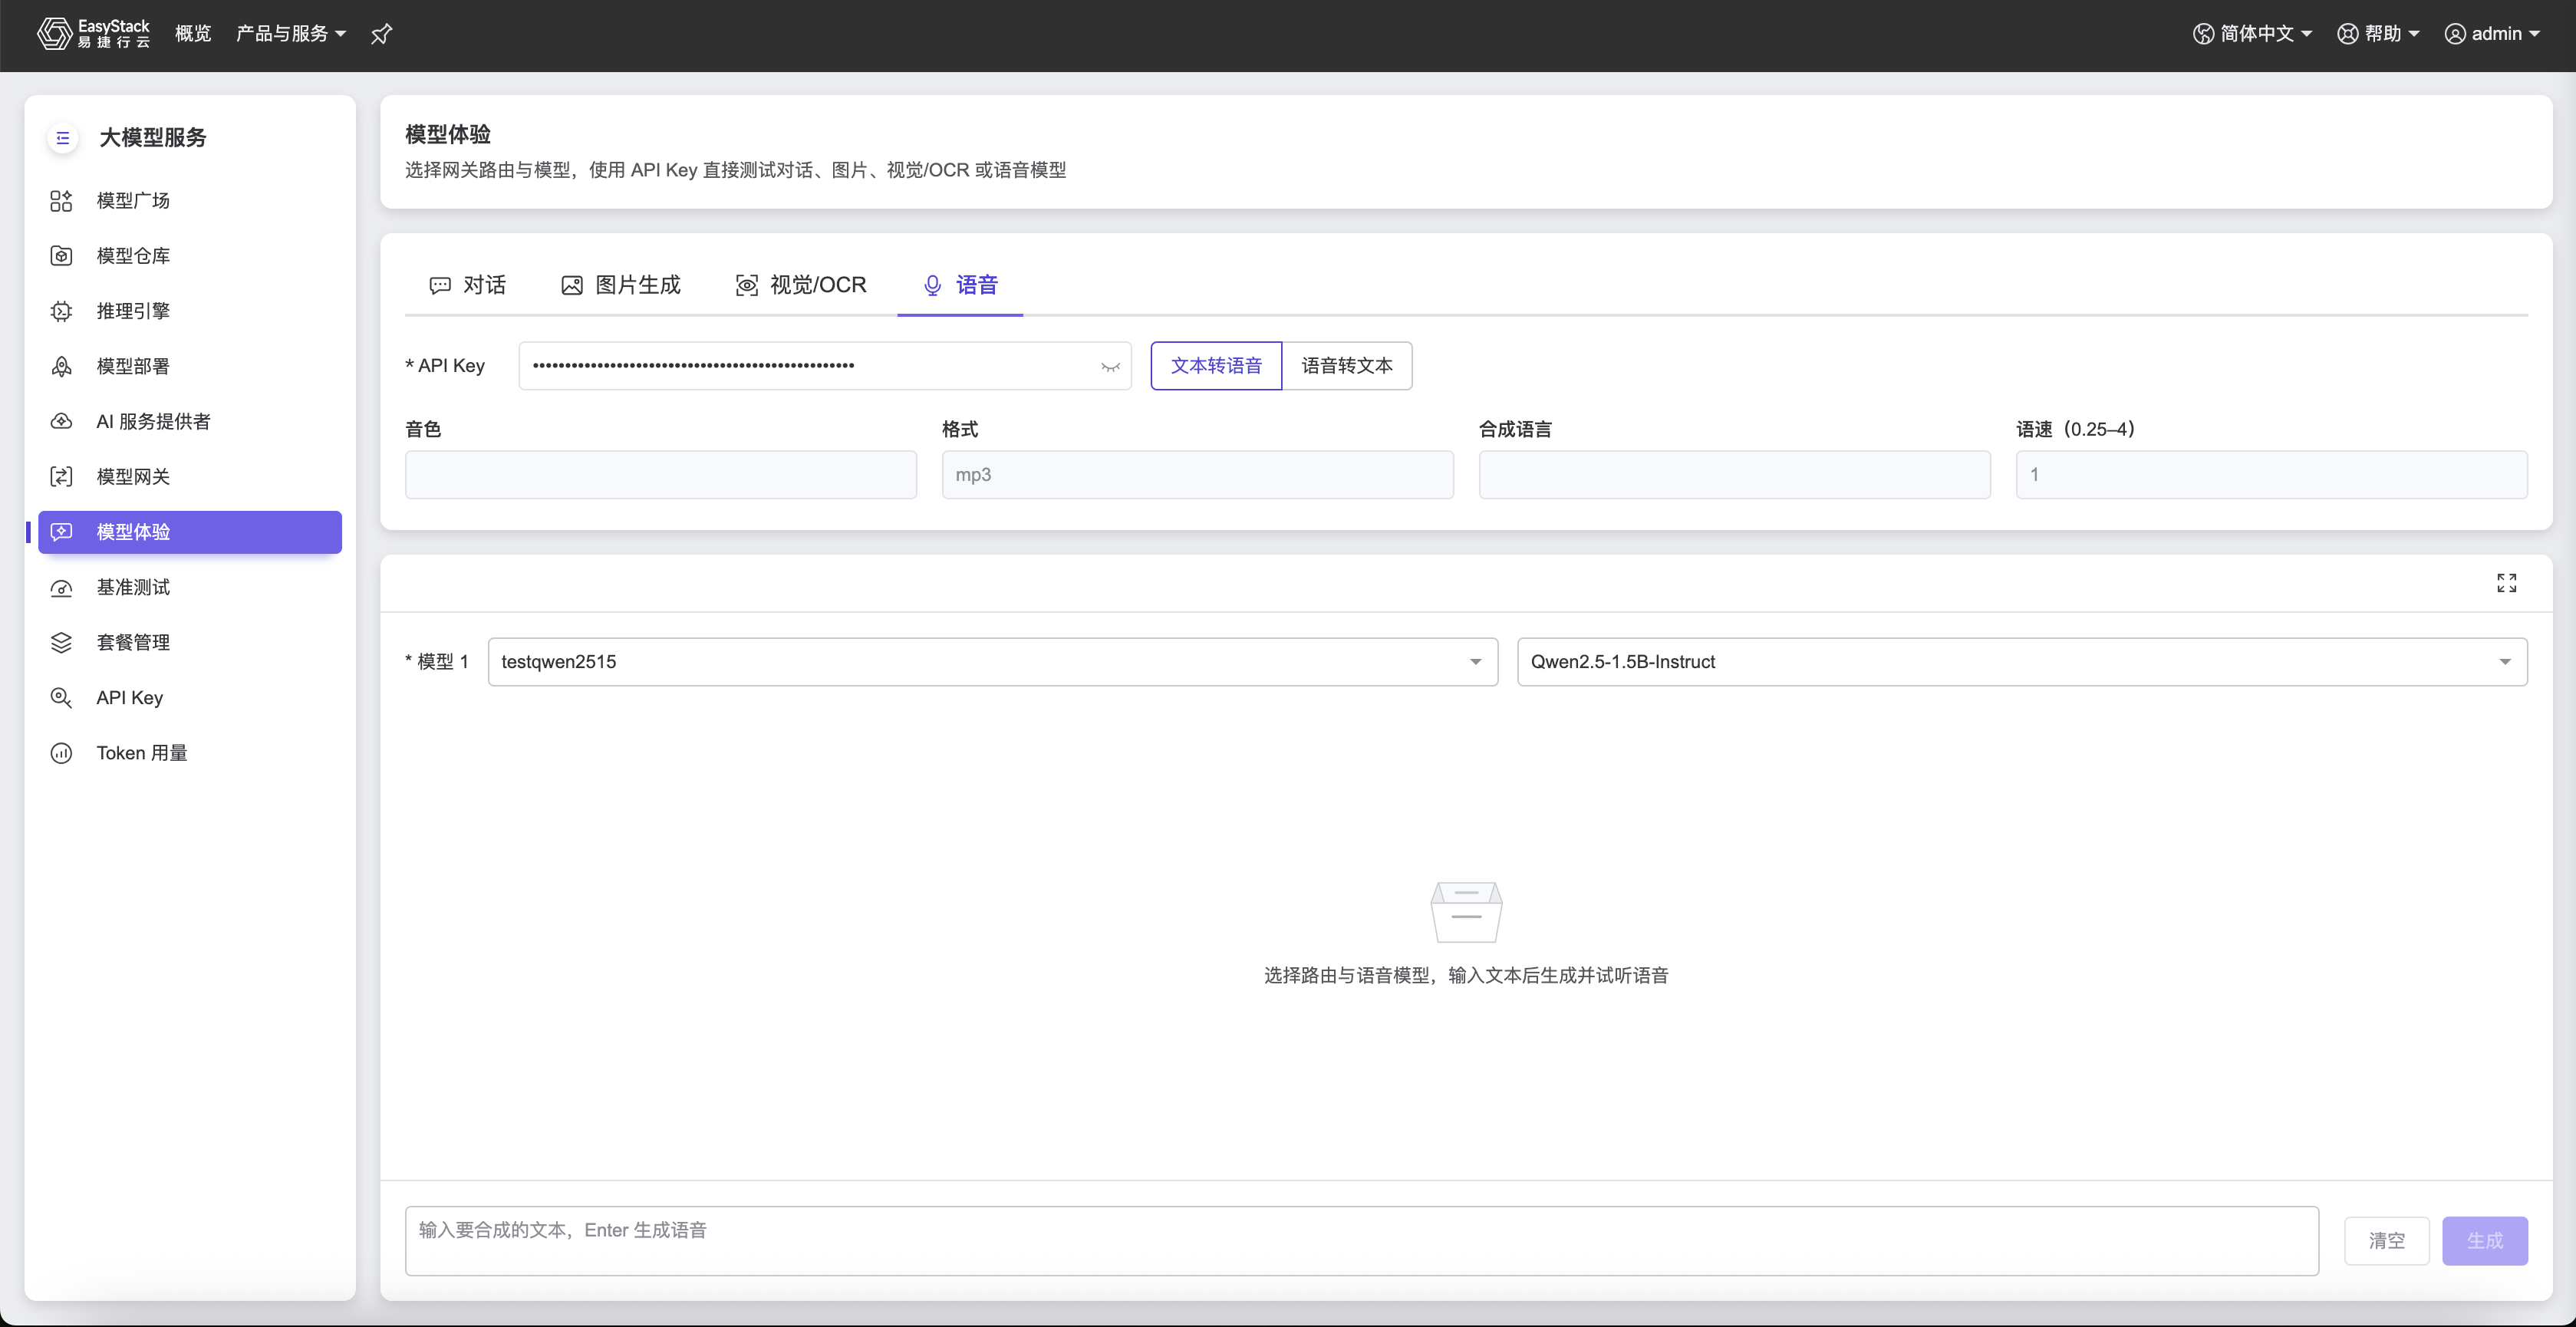
文本转语音用于将输入文本转换为语音。
- 在“模型体验”页面中,选择
语音页签。 - 选择
文本转语音。 - 填写API Key。
- 配置语音生成参数。
- 选择目标路由和语音模型。
- 在页面底部输入需要合成的文本。
- 单击
生成或按Enter键,生成并试听语音。
| 参数 | 说明 |
|---|---|
| 音色 | 生成语音使用的音色。 |
| 格式 | 生成语音的文件格式,例如MP3。 |
| 合成语言 | 生成语音使用的语言。 |
| 语速 | 生成语音的播放速度,可配置范围为0.25~4。 |
如果当前选择的模型不支持文本转语音,页面将显示相应提示。此时需要重新选择支持该能力的路由和模型。
需要清除当前文本和生成结果时,可单击清空。
语音转文本
语音转文本用于将语音内容转换为文本。
- 在“模型体验”页面中,选择
语音页签。 - 选择
语音转文本。 - 填写API Key。
- 选择目标路由和支持语音转文本的模型。
- 根据页面提示添加需要识别的语音并执行转换。


